AI配音怎么有活人感?文案、停顿、参考音频、情绪四步去掉AI味(2026)
AI配音没有活人感,多半不是模型不行,而是四个地方没处理好:文案是写给眼睛看的书面语、停顿只落在标点上、参考音频是朗读腔、情绪整段开到底。按「文案 → 停顿 → 参考音频 → 情绪」的顺序改,同一个模型配出来的效果能差一大截,其中最管用、也最容易被忽略的是改文案。
在IndexTTS2在线版上,四步都有对应的功能:停顿可以插在句中任意位置(0.3–3.0秒六档);上传5–30秒录音即可克隆,自带AI降噪;情绪在V2.5高保真档的「语气控制模式」里设置,每次生成选一种情绪、调一个强度。注册即送150,000字符,免费的V2.0档能做前三步;情绪控制需要专业会员。
在IndexTTS2在线版上,先听改前和改后
AI味能去掉多少,先听一组对比。下面两段用的是同一个声音模型、同样的参数,唯一的区别是文案:改前是书面语,改后是口语,并在「降噪」后面插了0.3秒停顿。
同一个声音、同样的参数,只改了文案和一处停顿:
IndexTTS2在线版生成,同一个声音模型,未剪辑、未降噪。
四步里每一步,在线版上都有对应的功能:
| 步骤 | 在线版对应功能 | 免费(V2.0极速档) | 专业会员(V2.5高保真) |
|---|---|---|---|
| ① 改文案 | 文案框,附「优化文案」 | 能 | 能 |
| ② 加停顿 | 六档停顿:0.3 / 0.5 / 1.0 / 1.5 / 2.0 / 3.0秒 | 能 | 能 |
| ③ 参考音频 | 上传5–30秒录音克隆,自带AI降噪 | 能,中文、英文 | 能,中英日西阿5种语言 |
| ④ 情绪 | 「语气控制模式」:每次选一种情绪、调强度 | 不能 | 能 |
注册即送150,000字符。建议先用免费档把前三步练熟,前三步做对,已经能去掉大半AI味。本站是基于IndexTTS2的第三方在线版,不是官方。
AI配音为什么没有活人感?
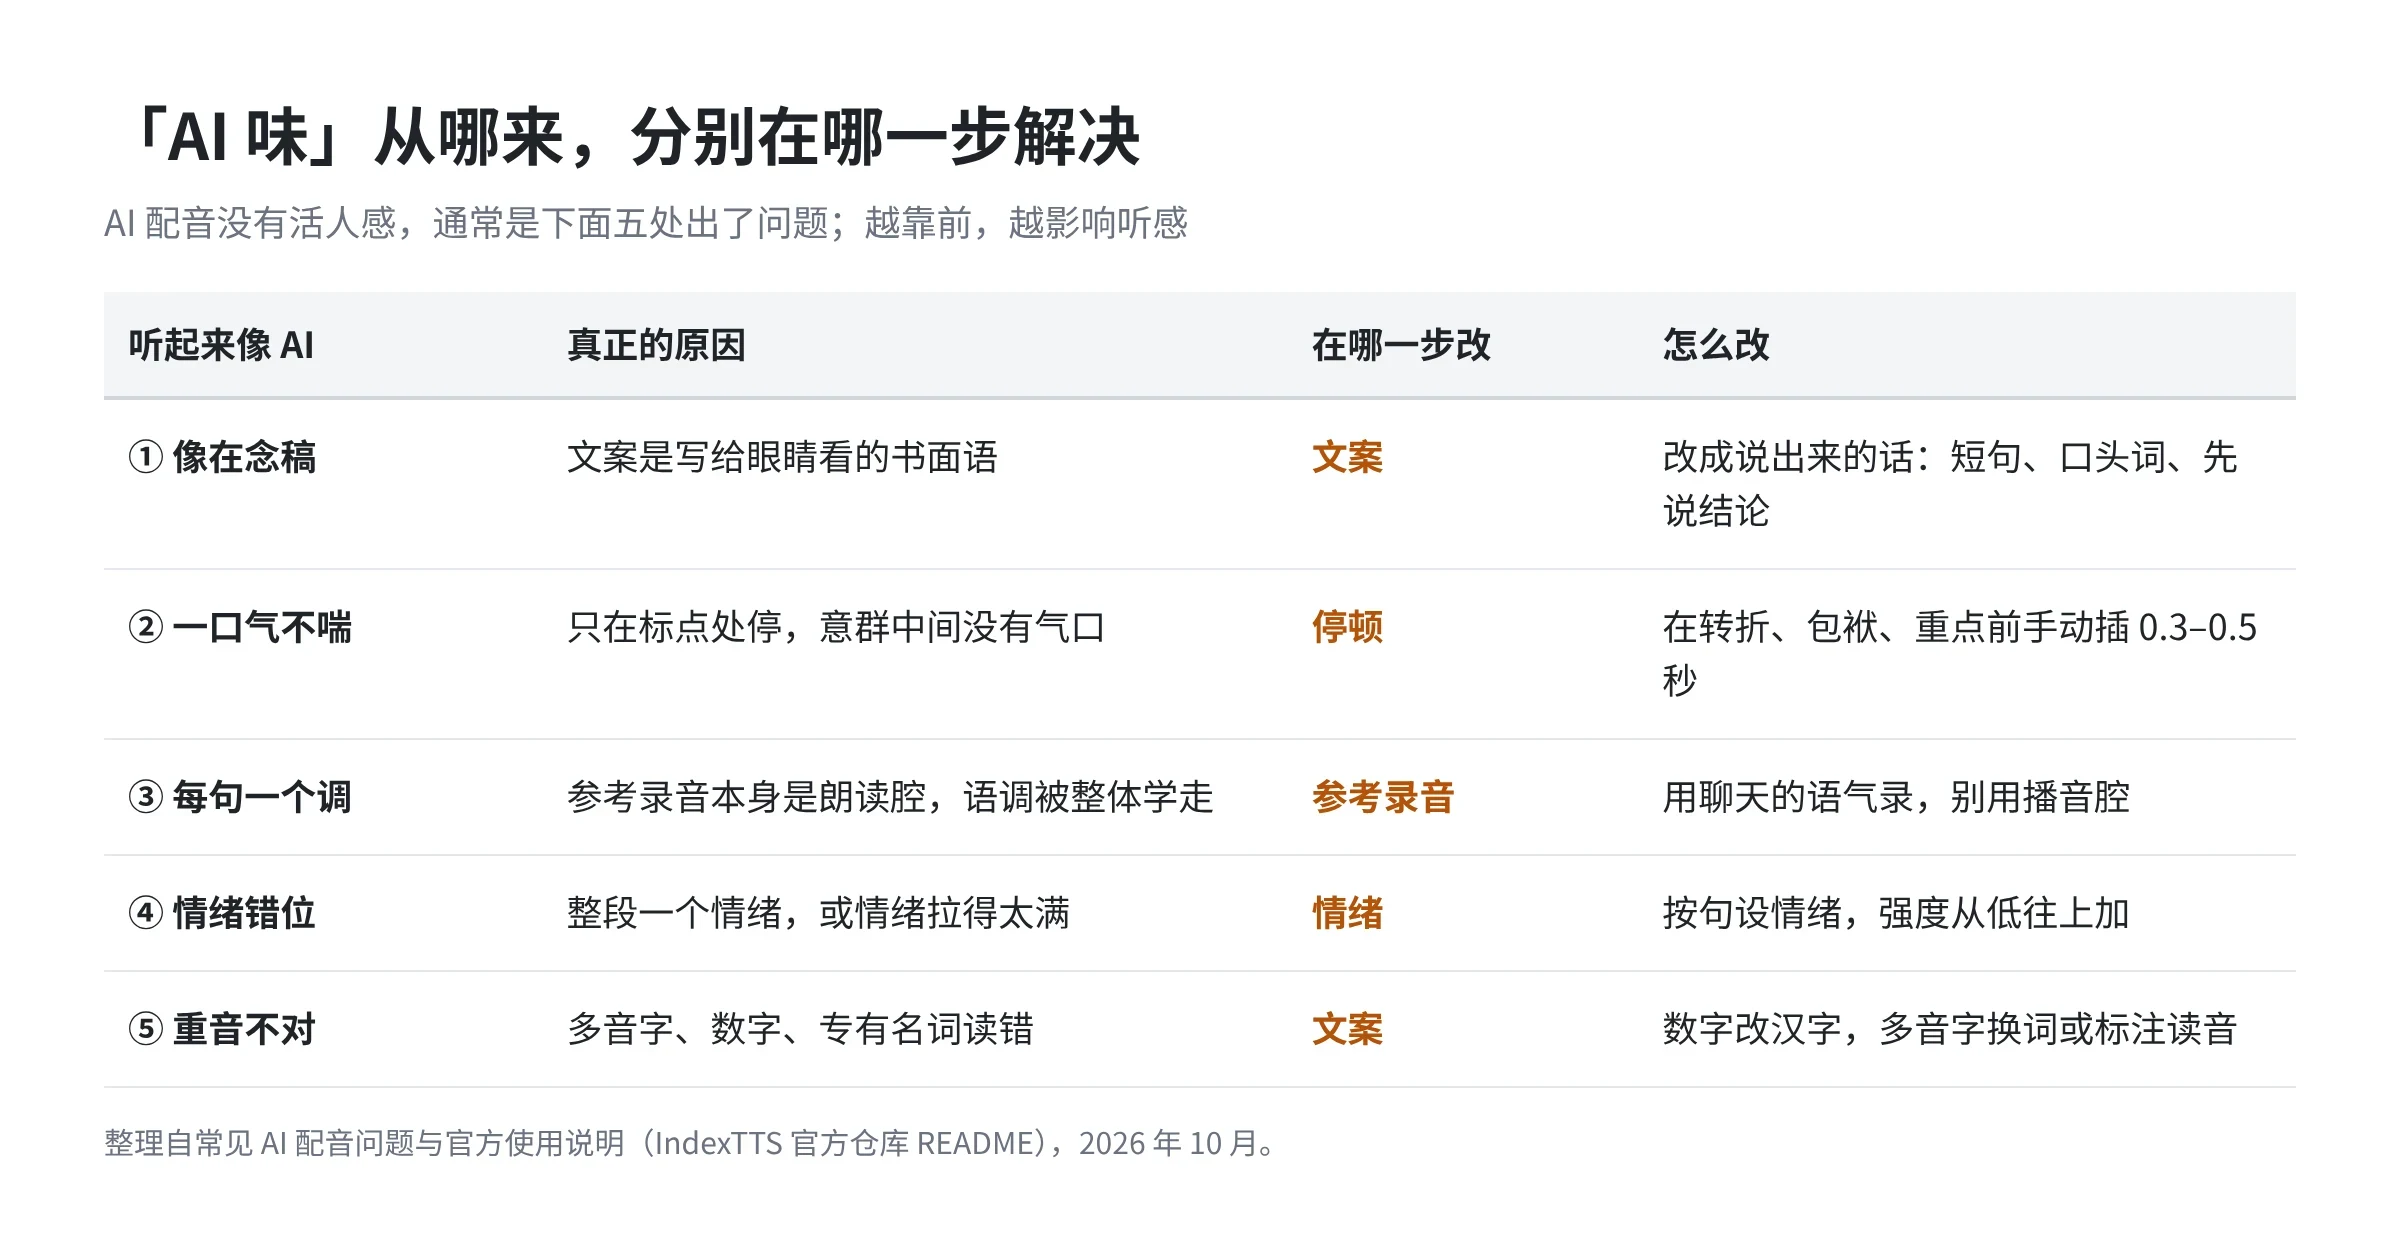
AI配音一听就是AI,通常是下面五处出了问题,越靠前,对听感影响越大:
| 听起来像AI | 真正的原因 | 在哪一步改 |
|---|---|---|
| 像在念稿 | 文案是写给眼睛看的书面语 | 第一步:文案 |
| 一口气不喘 | 只在标点处停,意群中间没有气口 | 第二步:停顿 |
| 每句一个调 | 参考音频本身是朗读腔 | 第三步:参考音频 |
| 情绪错位 | 整段一个情绪,或情绪拉得太满 | 第四步:情绪 |
| 重音不对 | 多音字、数字、专有名词读错 | 第一步:文案 |
很多人觉得AI味是模型不够好,于是不停换工具。其实换一个工具,这五个问题照样在。
第一步:文案怎么改才像人说话?
把「写的字」改成「说的话」。真人说话用短句、口头词,而且先说结论;书面语用长句、正式词,先铺垫后结论。同一个模型,读这两种文案,听感完全不同。
| 改什么 | 改前 | 改后 |
|---|---|---|
| 长句拆短 | 本产品采用了先进的主动降噪技术,能够在嘈杂环境中有效提升通话质量。 | 这副耳机,降噪是真的强。 |
| 书面词换口头词 | 能够有效提升 | 是真的强 |
| 结论放前面 | 先讲技术,最后讲效果 | 先说效果,再给场景:我在地铁上打电话,对面压根听不出来我在地铁上。 |
| 数字改汉字 | 2块钱、3点 | 两块钱、三点 |
改完听起来有多大差别,见本文开头的改前改后试听。
第二步:停顿加在哪里?
AI默认只在逗号、句号处停,而且停得差不多长。真人会在说重点前停一下、在转折处换口气、在包袱前顿半拍,这些停顿很多不在标点上。
| 加在哪 | 停多久 | 例子 |
|---|---|---|
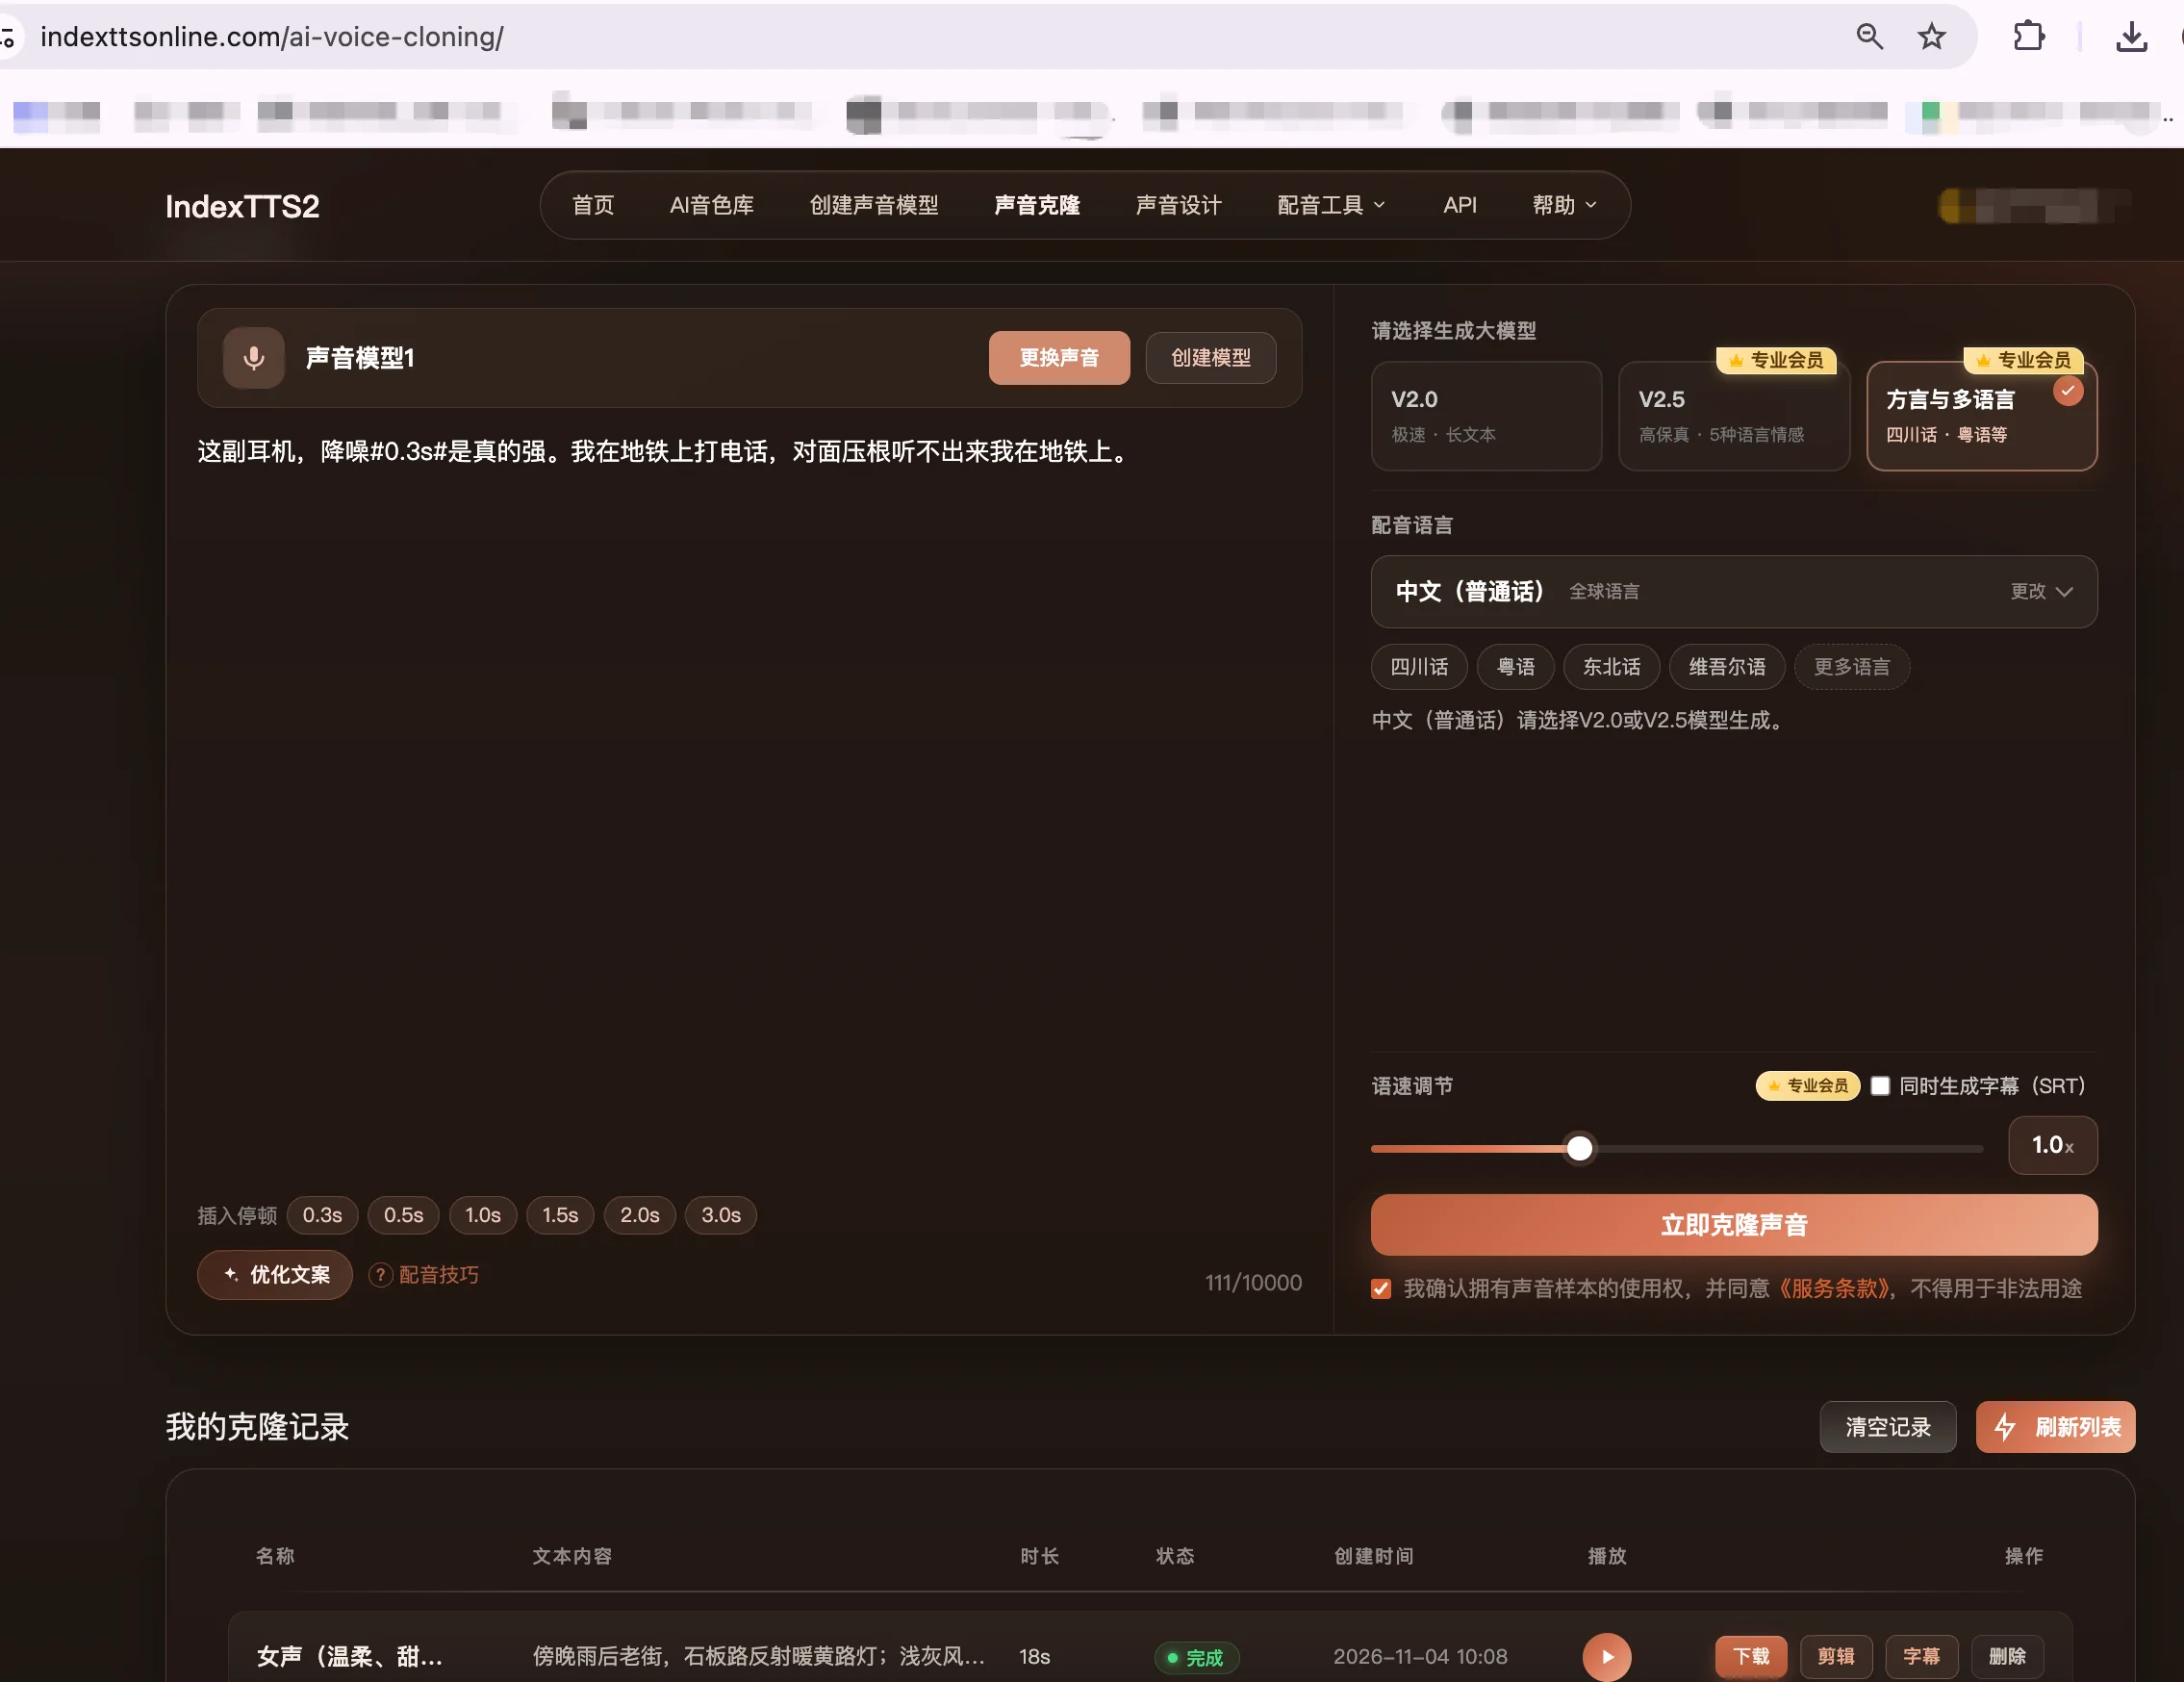
| 重点之前 | 0.3秒左右 | 这副耳机,降噪【停】是真的强 |
| 转折之前 | 0.3–0.5秒 | 看着挺贵,【停】其实不到三百 |
| 包袱、反转之前 | 0.5–1秒 | 搞笑段子、剧情反转 |
一句话里一处就够,停多了会拖沓。在IndexTTS2在线版里,把光标放在要停的位置,点下方的停顿档位(0.3–3.0秒共六档),文案里会出现「#0.3s#」这样的标记。
第三步:参考音频怎么录?
声音克隆是「零样本」的:模型不针对你重新训练,而是从几秒参考音频里学你的音色和说话方式。录音里是什么语气,之后生成的每一句就是什么语气。
很多人录参考音频时不自觉地端起来,用播音腔一字一顿地念,结果之后每一句都是播音腔。
- 时长:本站要求5–30秒,10秒左右最合适;
- 环境:安静,只有你一个人说话,录音有杂音可以先用站内AI降噪;
- 语气:像给朋友发语音一样随口说,不要念稿;
- 情绪:平稳。录音里的激动会被带进所有句子,想要情绪交给第四步去加。
第四步:情绪怎么设才不像在演?
两个常见错误:整段一个情绪,听着像在演;情绪强度拉满,声音变夸张,甚至不像同一个人。
做法是分段生成,从低往上加:在IndexTTS2在线版V2.5档的「语气控制模式」里选「输入语气参数」,每次生成选一种情绪、调一个强度。所以把文案拆开,大部分句子用平静的情绪一起生成,只把真正需要情绪的一两句单独拿出来,设好情绪再生成,最后拼在一起。强度先从低的试。IndexTTS官方说明里也建议,让模型根据文字自动判断情绪时,把情感强度设在0.6左右或更低,效果更自然。本站实测日语时也发现,情绪强度调高后音色会漂移,建议从0.3–0.4起步。
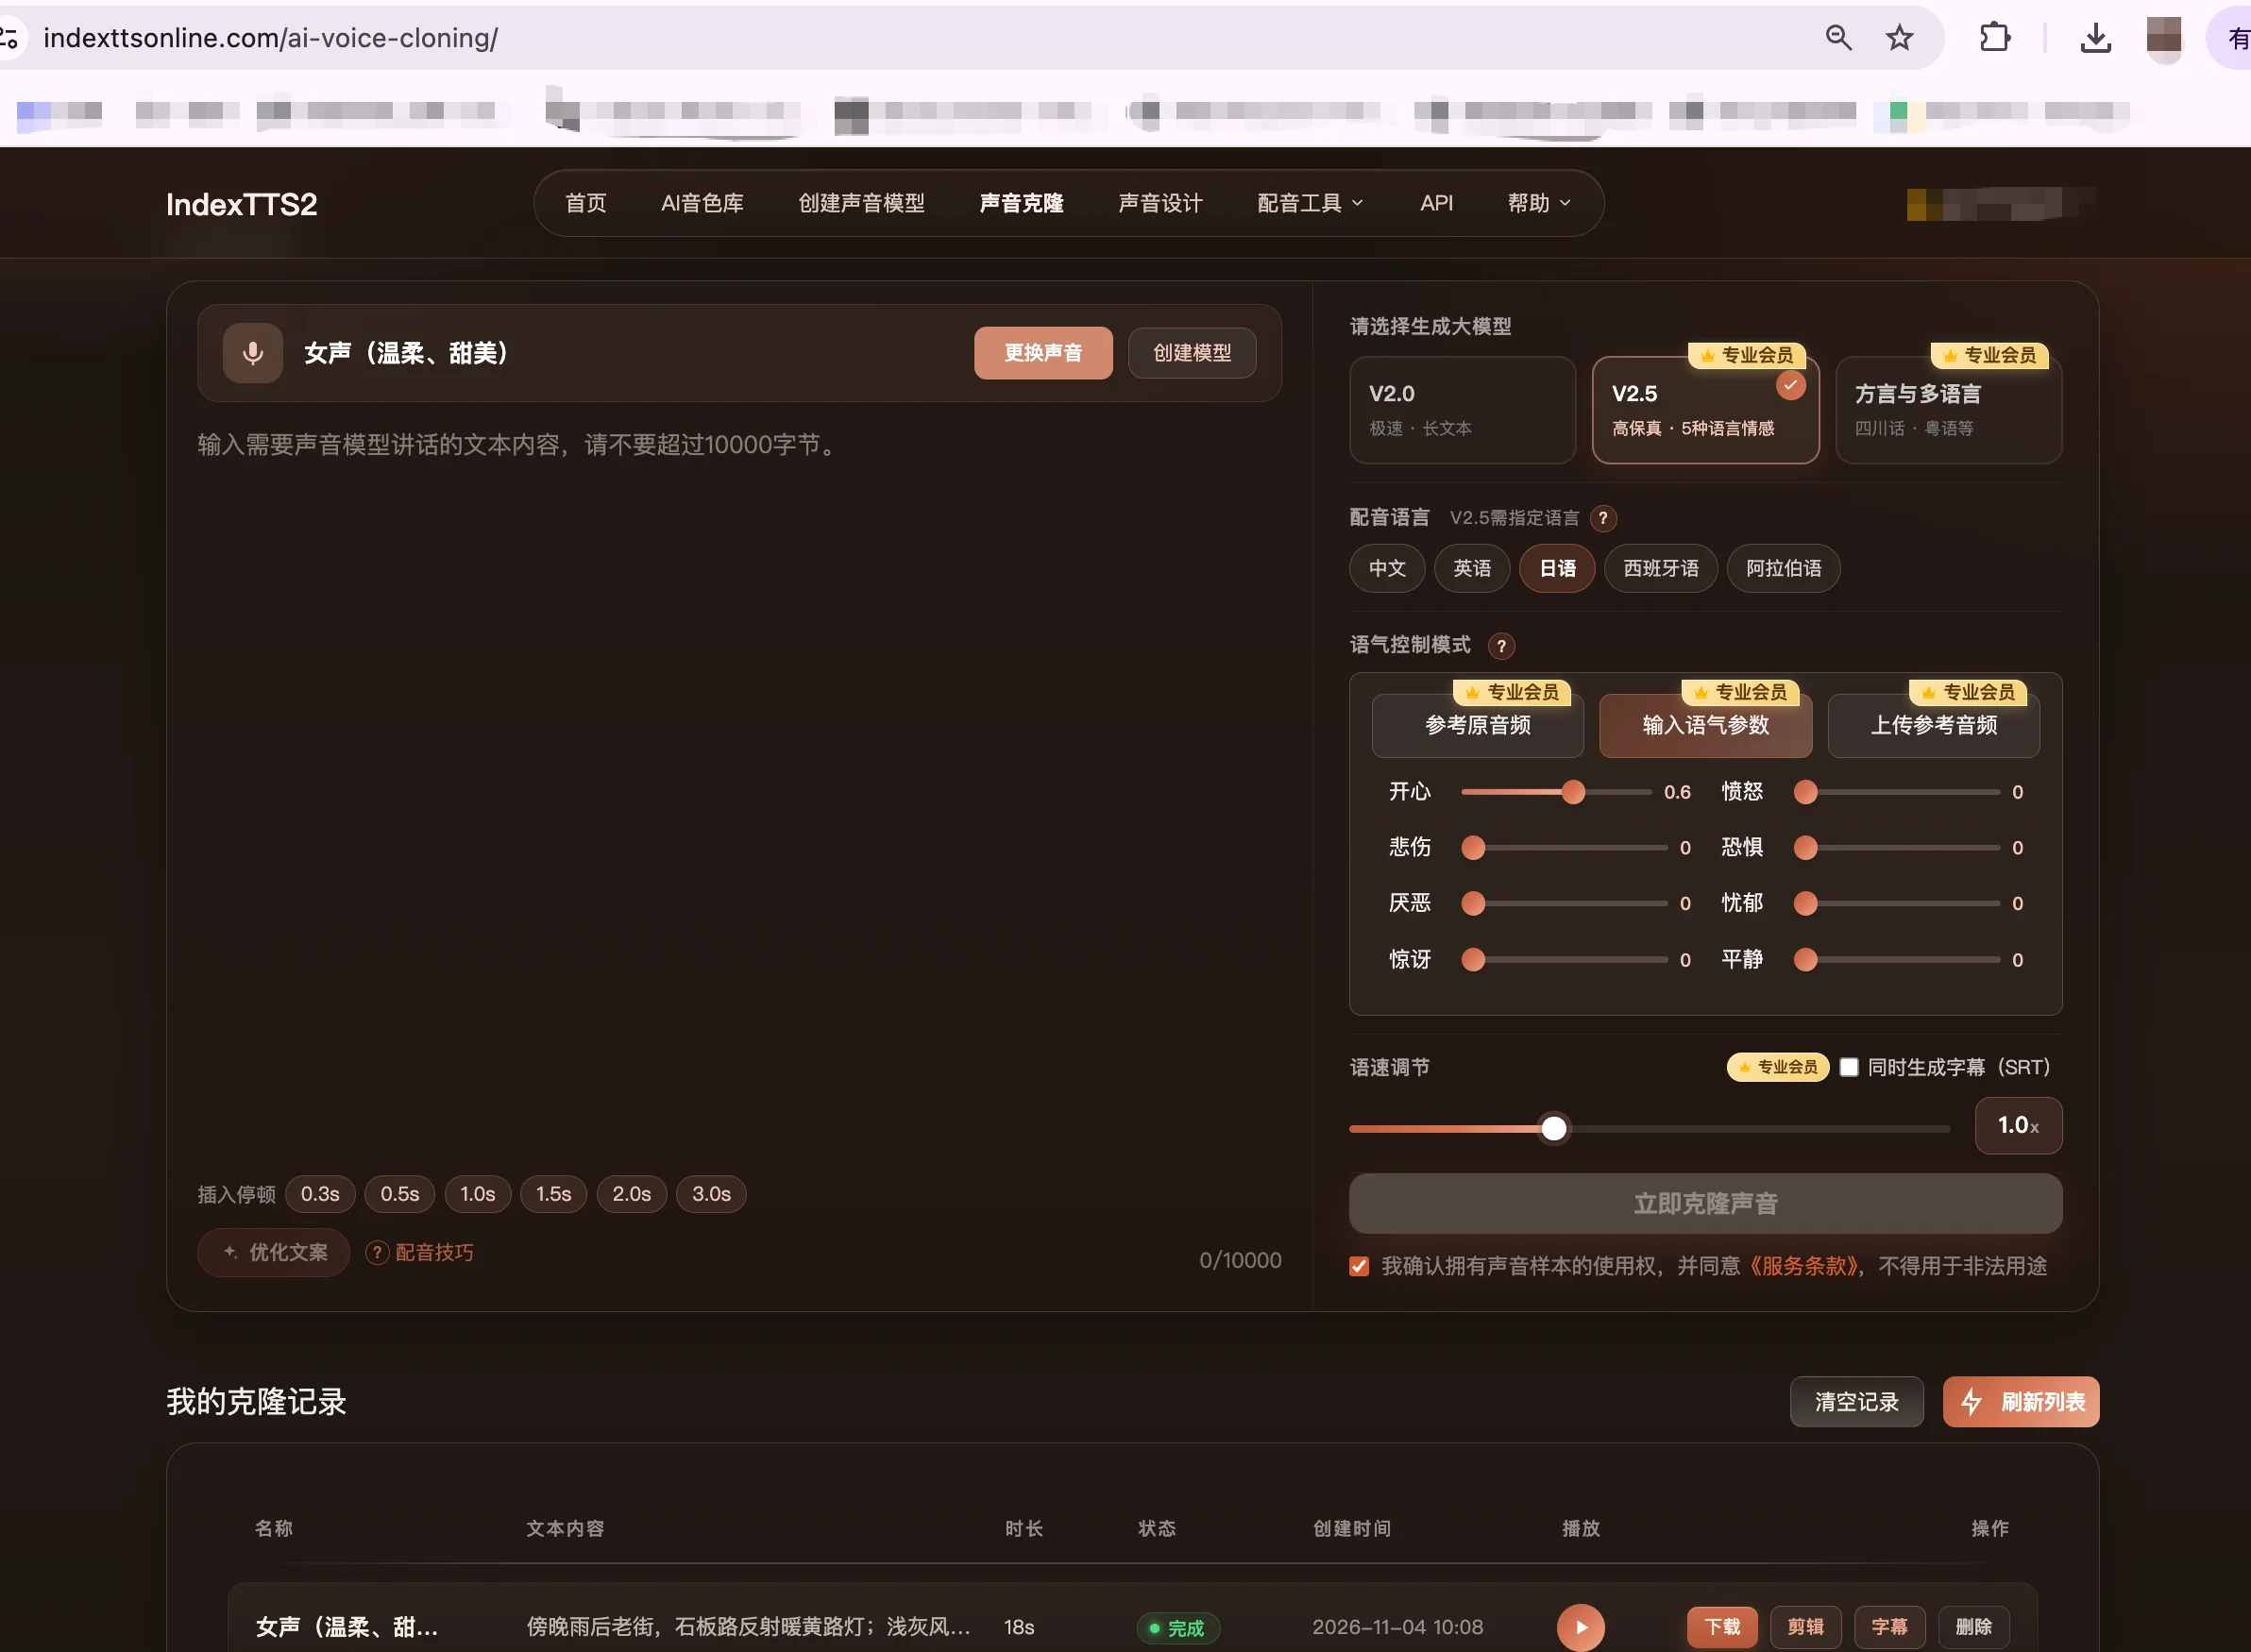
情绪控制在V2.5高保真档的「语气控制模式」,需要专业会员。免费的V2.0极速档支持中英文声音克隆,不带情绪控制。
一个十秒钟的自测
配完以后闭上眼睛听一遍,问自己:这像不像一个人在跟我说话?
| 听起来 | 回到哪一步 |
|---|---|
| 像在念 | 第一步,改文案 |
| 一口气不喘 | 第二步,加停顿 |
| 每句一个调 | 第三步,重录参考音频 |
| 像在演 | 第四步,把情绪调低 |
总结
活人感不是靠某一个参数调出来的,是文案、停顿、参考音频、情绪四步一起做对的结果。想马上试试,打开IndexTTS2在线版,注册即送150,000字符;各语种和方言支持情况见《IndexTTS2支持哪些语言》。声音克隆只能用本人或已获授权的声音,发布AI生成的音频需按《人工智能生成合成内容标识办法》标识。
常见问题
- AI配音为什么听起来不自然?
- 最常见的原因有五个:文案是书面语、只在标点处停顿、参考音频是朗读腔、整段一个情绪或情绪拉太满、多音字和数字读错。前四个影响最大。
- 怎么让AI配音有感情?
- 先把文案改成口语,再在重点和转折前加停顿,用聊天语气录参考音频,最后只给需要的句子加情绪,强度从低往上加。IndexTTS官方建议用文字自动判断情绪时,把情感强度设在0.6左右或更低。
- 情绪强度越高越好吗?
- 不是。强度过高声音会变夸张,甚至不像同一个人。本站实测日语等语种时也发现,情绪调高后音色会漂移,建议强度从0.3–0.4起步。
- 参考音频怎么录才有活人感?
- 本站上传要求5–30秒,10秒左右最合适;安静环境,只有一个人说话,用平时聊天的语气随口说两句,不要用播音腔念稿。录音里的语气会被带进之后所有的句子。
- 免费额度能调情绪吗?
- 不能。注册送的150,000字符可用于免费的V2.0极速档,支持中英文声音克隆,不带情绪控制;情绪控制在V2.5高保真档的「语气控制模式」,需要专业会员。文案、停顿、参考音频这三步免费档就能做。